在我们的上一篇博客中,我们介绍了什么是Token:它是AI读取、推理与生成内容的基础单元,也是整个AI经济赖以运转的货币。我们也看到Token的生成规模已经达到千万亿级别。本篇博客将探讨下一个问题:海量的Token究竟是在哪里产出?又是什么决定了Token的产出盈利水平?答案是一种全新工业设施——AI工厂,以及一项正快速成为AI基础设施领域最重要的指标:每瓦生成Token数。理解该指标的重要性,是读懂当下行业几乎所有重大决策的关键,小到芯片设计,大到数据中心建设,以及我们后面将要探讨的散热技术,皆是如此。
按照上一篇博客提到的规模,单个Token的生产成本已经被压缩到几分之一美分,而再乘以天文数字般的交易量,单Token成本就成了业务中举足轻重的数字。
在资源不变的前提下,提升单位资源产出的Token数量,将单Token生产成本降低一小部分,在巨大的业务体量下,节省的成本会累积成对业务起到决定性优势。这也正是超大规模运营商与AI实验室投入大量工程资源去优化一切和Token产出效率、生产成本相关环节的原因,包括模型效率、芯片设计,以及越来越受重视的芯片散热基础设施。
AI工厂:一类全新的工业设施
由此引出一个未来会高频出现的概念:AI工厂。
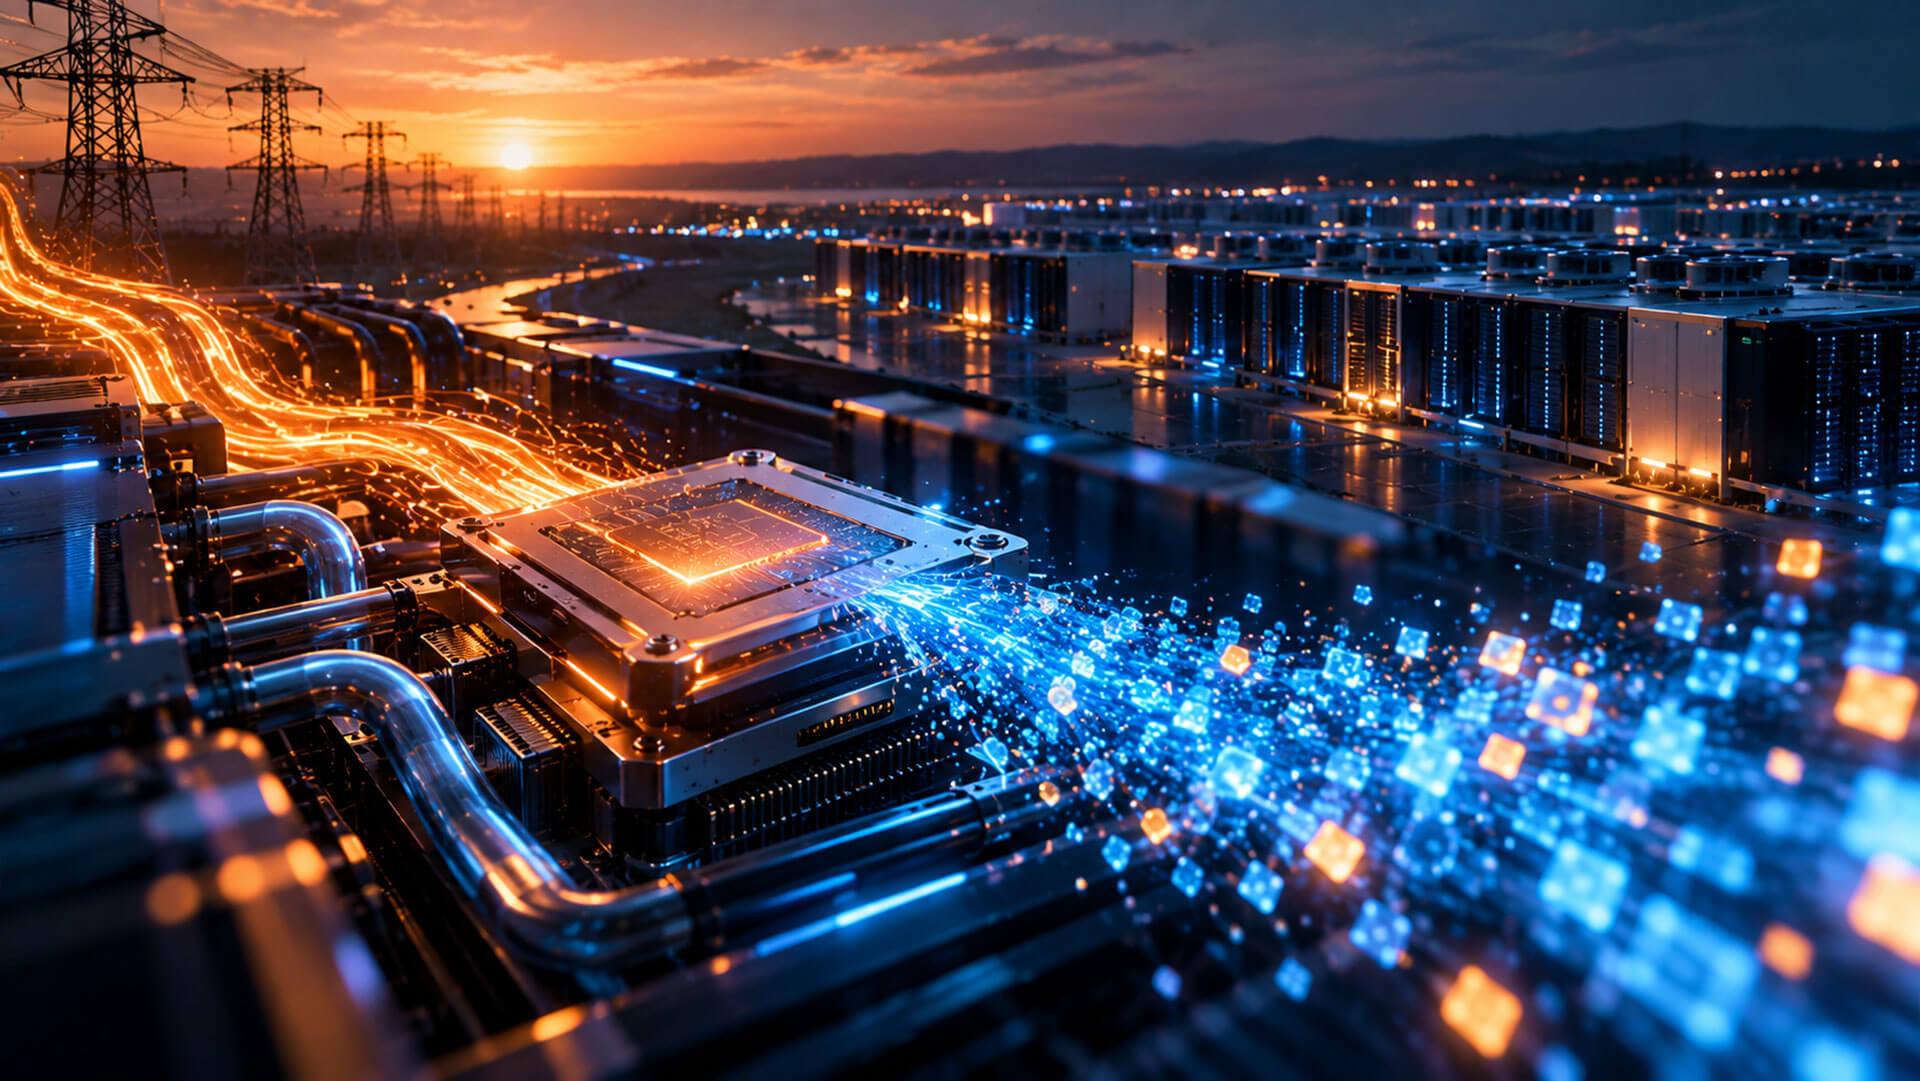
AI工厂顾名思义,是为单一产品——Token,专门建设的大规模设施。它不生产汽车、不生产钢材,也不直接制造半导体,只产出Token。一排排机架上的GPU(承担海量数学运算的专用芯片)消耗巨量电力,搭配日趋精密复杂的散热系统,全部只为实现一个目标:源源不断生成可供客户付费使用的Token。
把数据中心视作只输出一类可衡量产品的工厂,会彻底改变我们对它的评估逻辑。评价汽车工厂,会看每单位投资、每小时人力投入、每单位能源消耗能够产出多少台汽车。评估AI工厂也应当采用相同逻辑:它能产出多少Token,对应的成本又是多少?
没人预料到的核心约束
在计算机发展的绝大部分历史阶段,制约业务增长的核心约束是算力——芯片上可以集成多少晶体管、芯片的主频可以跑多快。到了云计算时代,约束转变为资本:你有多少钱可以用来新建数据中心。
进入AI时代,另一个约束一跃成为主导因素,很多行业从业者都对此始料未及:电力。不是算力,很多场景下甚至也不是资本,而是电力。
原因如下:AI工厂的电力消耗规模,已经给输配电物理基础设施带来巨大压力。公用事业并网排队、变压器容量、变电站扩建工程,这些工作周期漫长、成本高昂,同时还存在地理层面的限制,这和芯片制造完全不同。你无法像采购GPU那样,简单下单就获得更多电网供电容量。不少主流数据中心选址区域,监管机构已经直接对用电总量设置上限;公用事业企业告知客户,新增电网并网需要等待数年。部分运营方转而采用表后发电(Behind-The-Meter power generation)模式,也就是在厂区自建发电设施,试图绕开供电瓶颈。该方式能够起到缓解作用,但无法从根源消除电力稀缺的现状。
当一项资源真正进入稀缺状态,它的每一个单位都会变得珍贵,企业会围绕这项资源开展极致优化。当下AI工厂的电力资源就正处于这个阶段。运营方越来越把分配给厂区内的每一瓦电力视作战略资产:每一瓦电力都必须产出更多Token,因为Token就代表收入。
问题不止于电费本身。电力是厂区内一切业务的天花板。一座AI工厂对应数十亿美元的投入:土地、建筑、供配电散热基础设施、数万片GPU、互联网络,以及全天候运维的工程师与操作人员。无论厂区产出多或者少,以上成本全部都是固定成本。所以当电力被无效消耗,浪费的不只是电费,全部资本投入、硬件设备、场地、人力,都无法发挥出应有的价值。
认清这一点:电力属于稀缺资源,Token是电力转化之后的产出物。由此就引出所有严谨的AI基础设施讨论最终都会触及的问题:每消耗一瓦电力,究竟可以产出多少Token?
提出核心问题
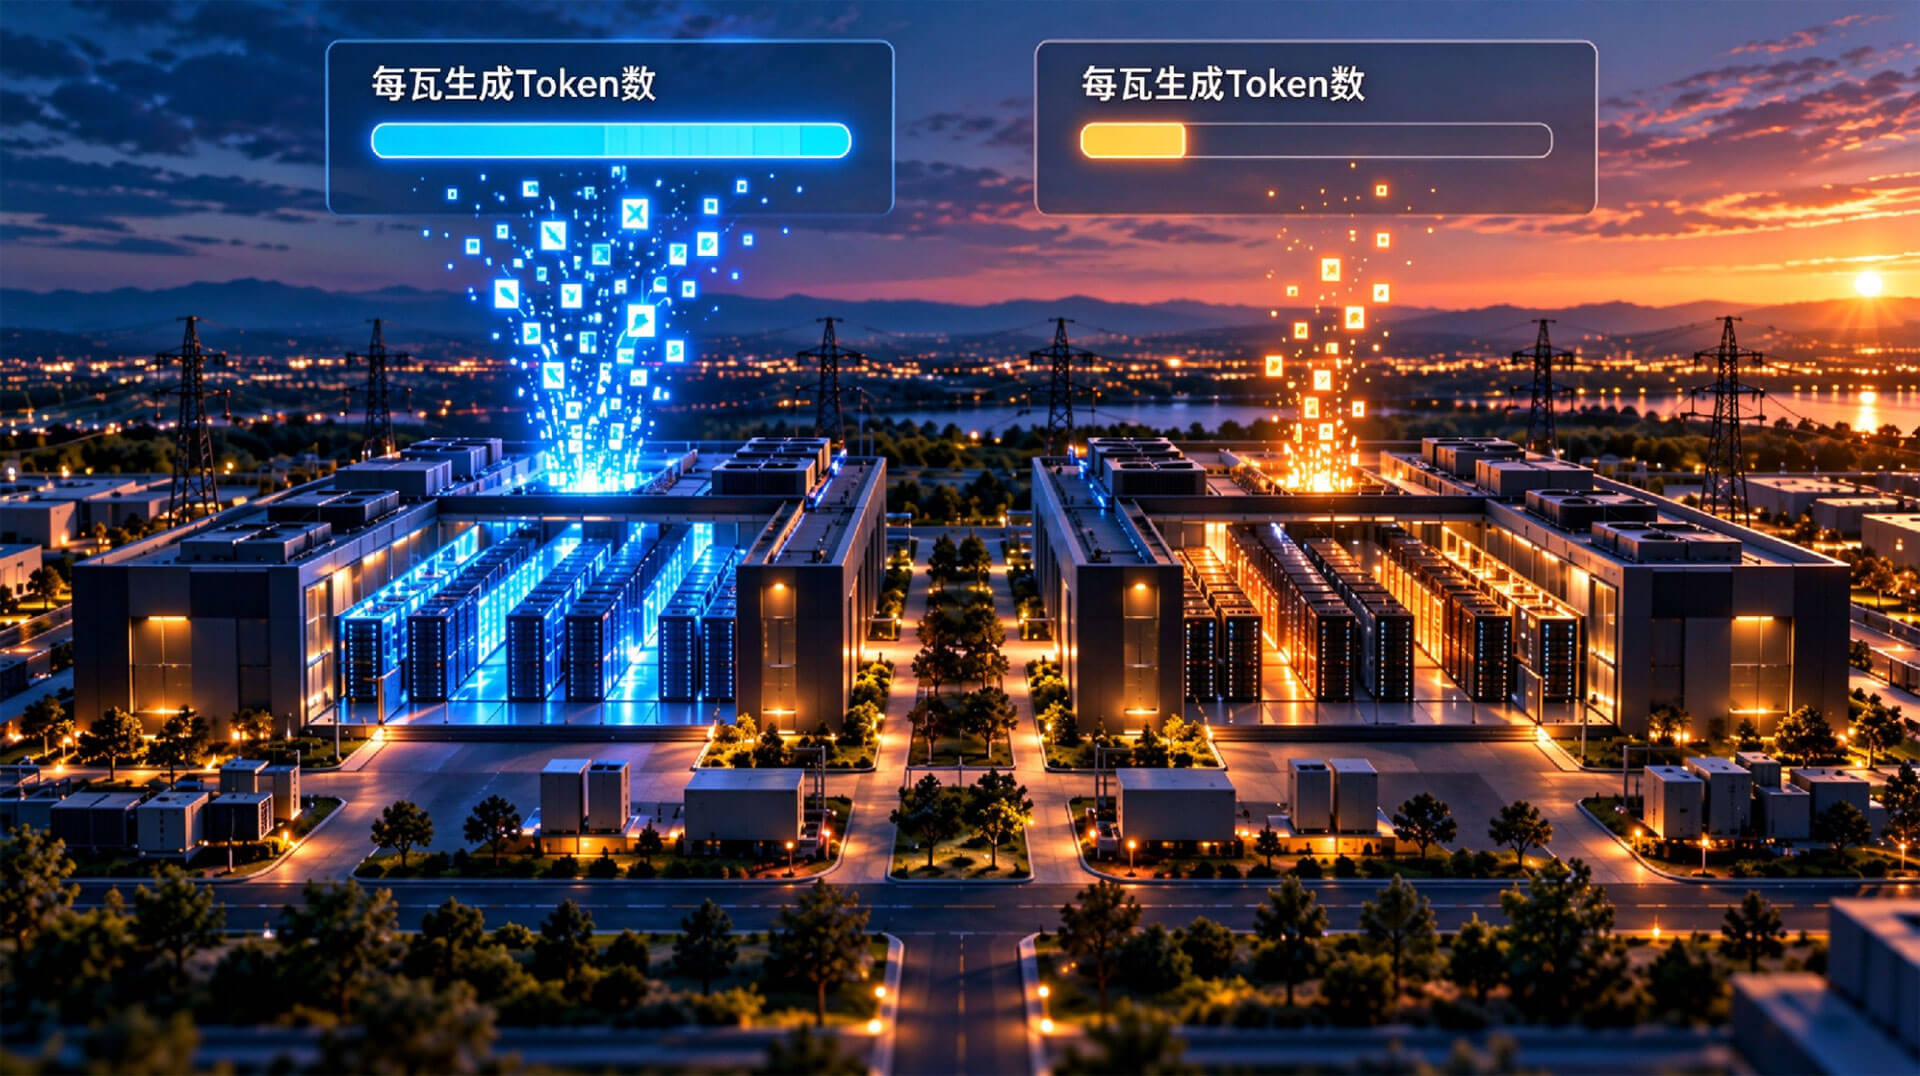
两座AI工厂,即便配置完全一致的GPU、电力合约、资本投入,最终可使用的产出总量依旧可能天差地别。造成差距的原因仅仅是其中一座工厂,把电力转化为Token的效率更高。在电力稀缺、每瓦电力都对应成本的行业环境下,该效率差距绝非可以忽略的微小误差。它决定了这座工厂是可以为全部投资带来可观回报,还是在白白消耗电力、资本被低效占用。
这个效率有对应的衡量指标,并且正快速成为AI基础设施领域最重要的指标:每瓦生成Token数。
以上就是每瓦生成Token数背后完整逻辑。它不是工程圈用来炫技的指标,而是物理约束在商业现实层面的直接体现。
为什么说它是核心指标,而非普通指标
我们需要厘清:为什么相比其他评估AI工厂性能的方式,每瓦生成Token数优先级更高。
你可以统计原始算力吞吐量:GPU每秒可以完成多少次数学运算。但该数值在硬件采购完成之后就已经固定;它只能反映硬件规格,无法体现工厂的实际运行水平。
你也可以统计Token总产出量。但是脱离其他背景信息,该数字没有参考意义,它只能说明工厂规模大,不代表运行效率高。
而每瓦生成Token数不一样:它直接把真正稀缺的资源(电力)和真正产生营收的产出(Token)建立对应关系。同时,电力供给上限就是AI工厂规模的硬性天花板,所以每瓦生成Token数,实质上决定了运营方争取到的每一瓦电力可以带来多少盈利。在电力受限的行业环境中,这几乎就是业务的全部。
看一个实际推论:当你无法获取更多电力,也很难拿到效率更高的新一代GPU(同一代芯片出厂之后,芯片本身的效率基本定型),那么对于已经建成的厂区,想要提升Token总产出(也就是提升营收),唯一可行路径就是提升现有电力资源的Token产出效率。每瓦生成Token数每提升一个百分点,盈利能力就同步提升一个百分点。同时,也会提高厂区全部配套投入——建筑、硬件、运维人员的投资回报率。
一个近在眼前的优化机会
当被问到如何提升AI工厂的每瓦生成Token数,大部分人会想到性能更强的芯片、效率更高的模型架构、更智能的调度软件。以上方向固然重要,但还存在一个更大的优化空间。
GPU芯片一旦完成设计、制造并部署上线,硅片本身的效率就被锁死。你无法对晶体管做回溯式重新设计,芯片的硬件能力已经定型。软件层面优化确实能够带来增益,但会受限于硅芯片本身硬件架构。
但是,还有一项条件可以持续、大幅地调整:硅芯片的运行温度。
这正是很多人会感到意外的地方:GPU芯片结温会对每瓦生成Token数产生巨大的直接影响;哪怕芯片已经交付部署完成,运营方依旧可以通过工程手段主动调控该变量。同一片GPU,功耗维持不变,运行温度越低,产出的Token就越多;温度越高,Token产出就越少。这不是微弱的边际效应。对于已经部署上线的硬件集群,这是提升每瓦生成Token数效果最显著的抓手之一;而温度几乎完全由芯片导热排热的基础设施决定。
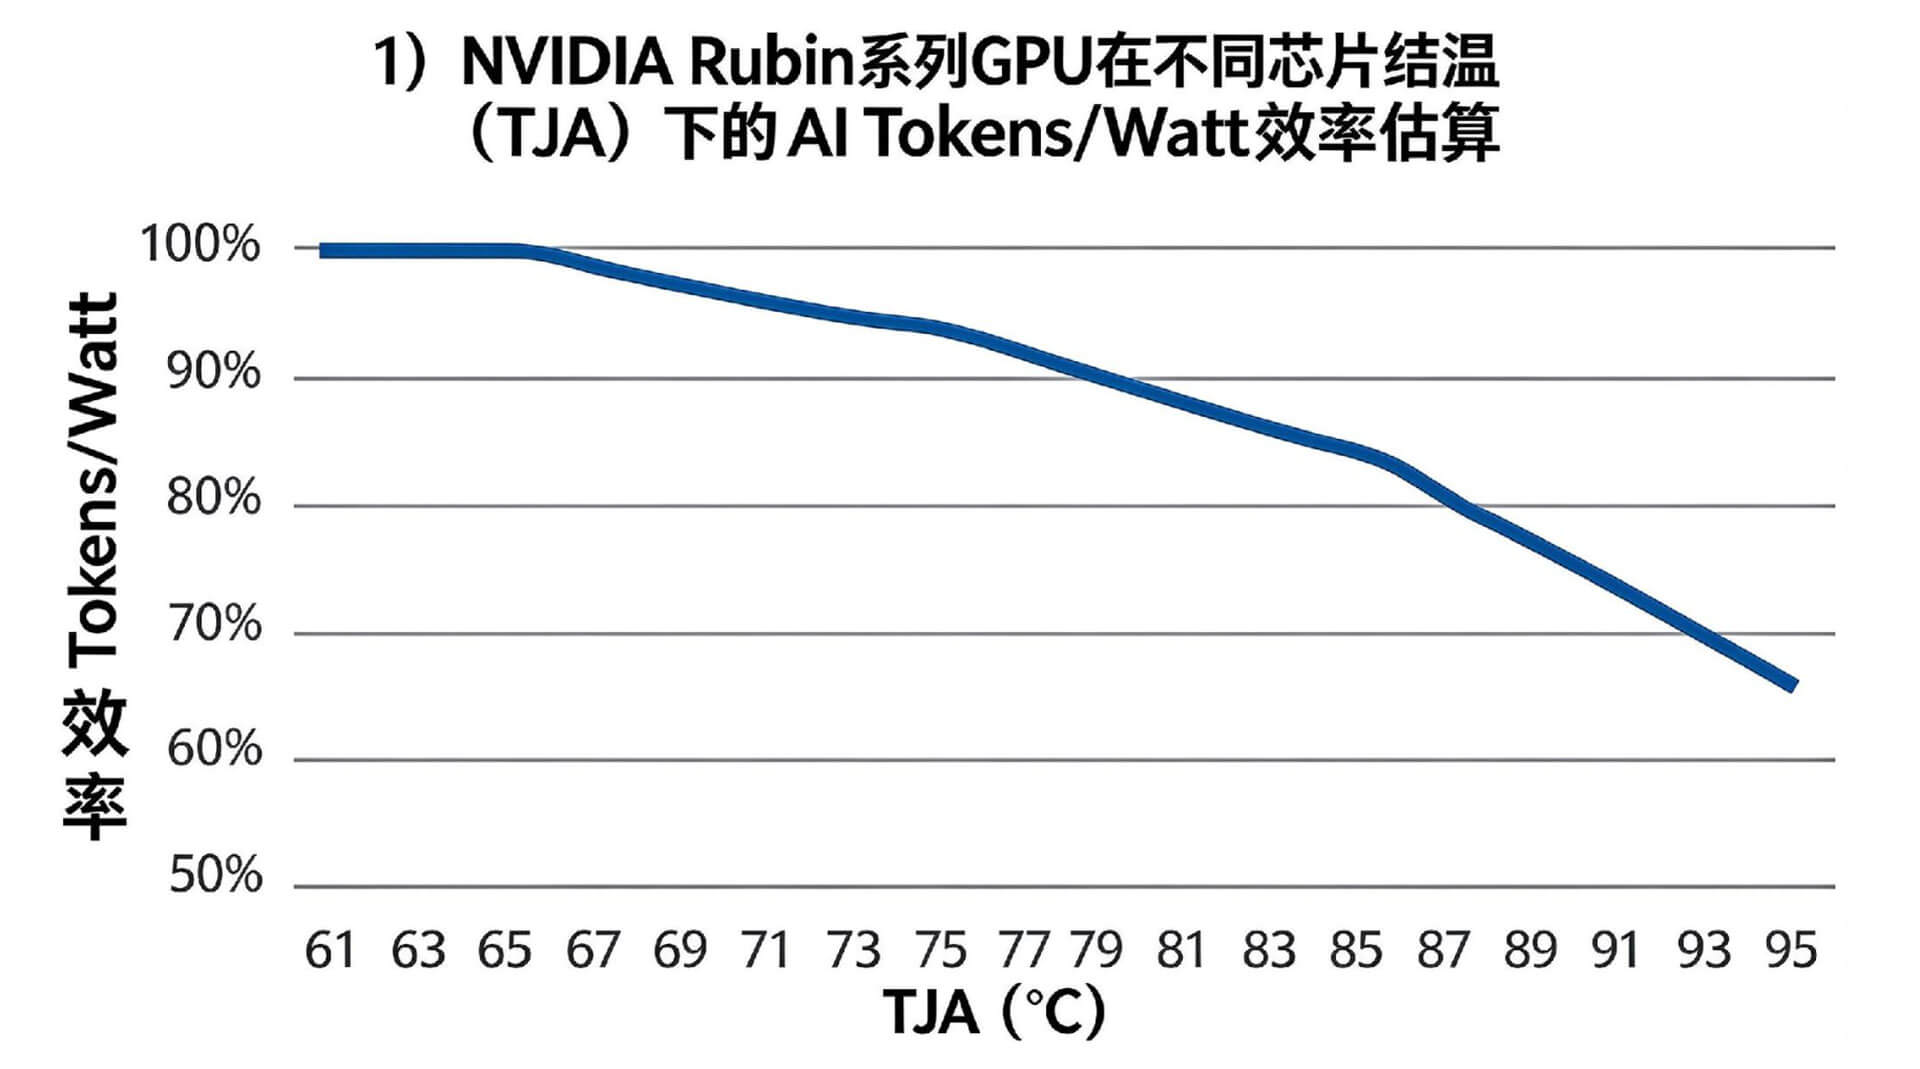
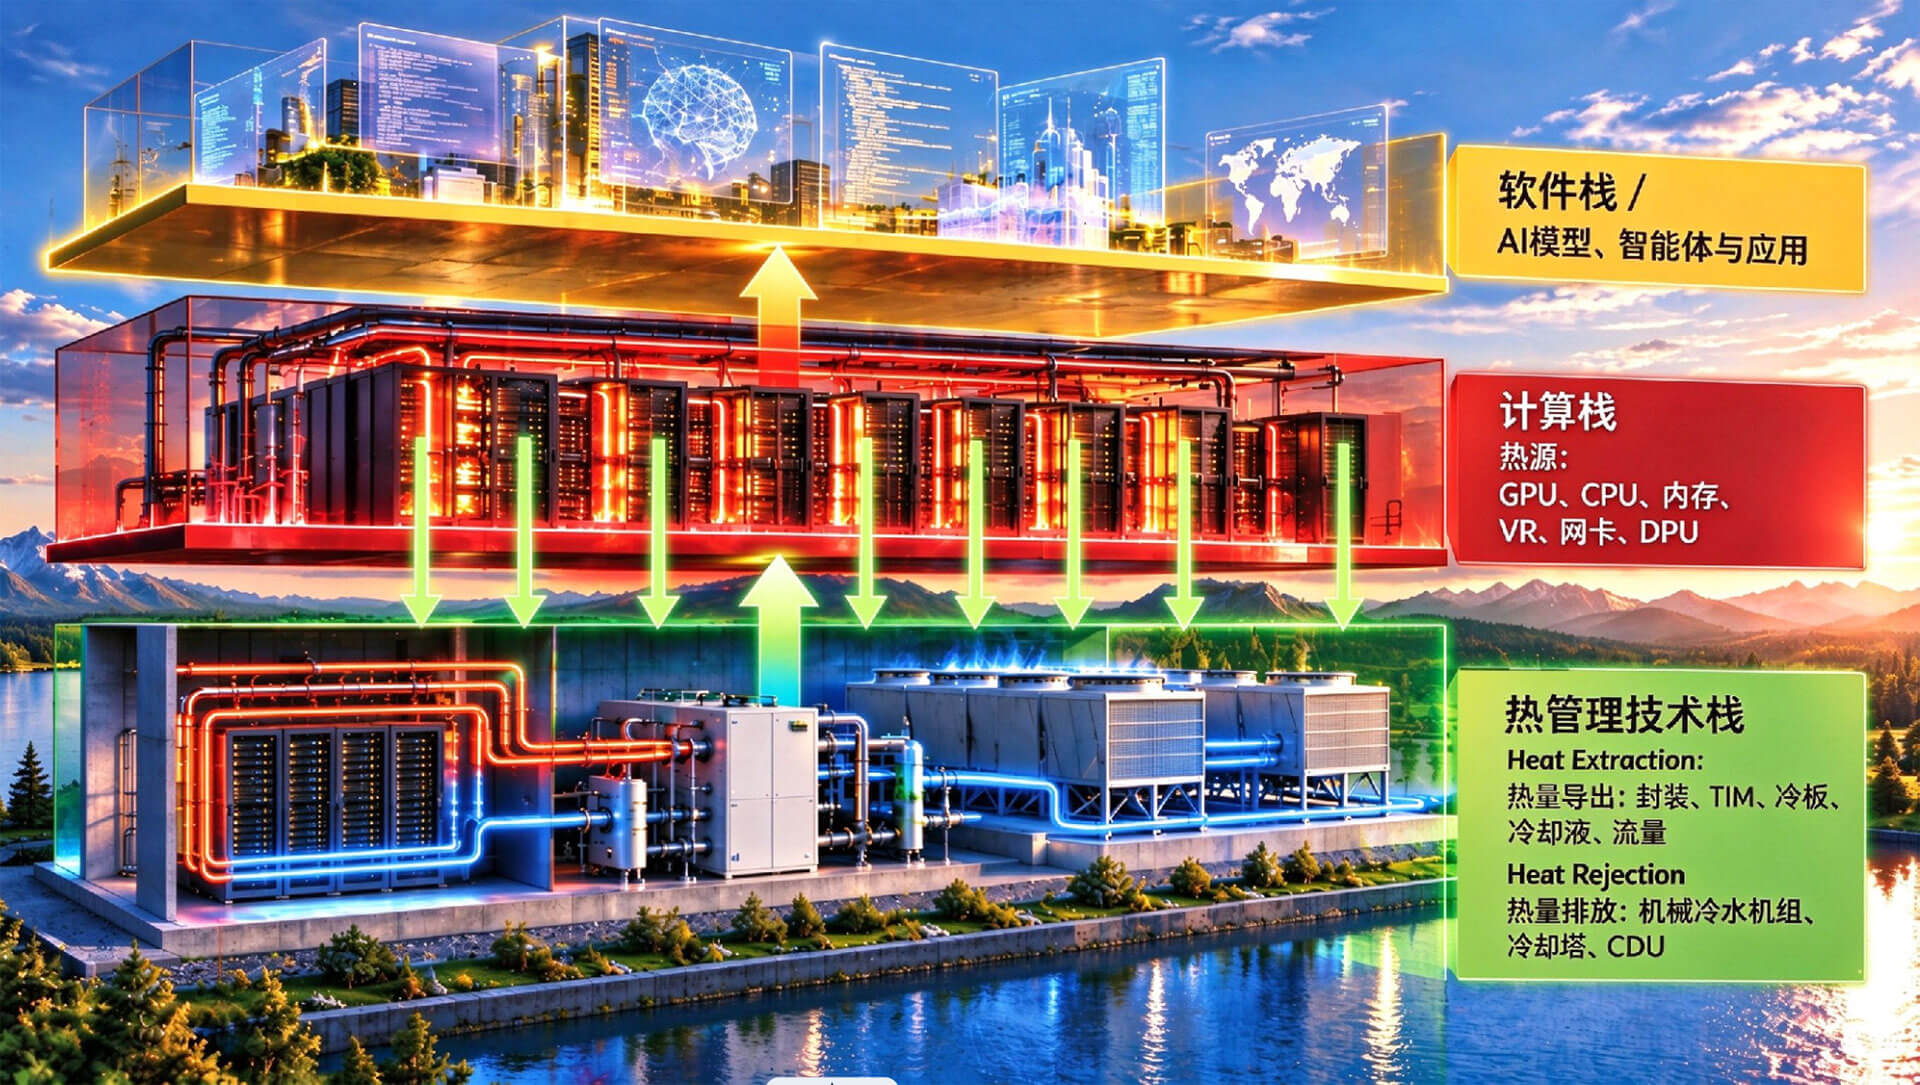
这套基础设施叫做热管理技术栈(Thermal Stack)。它覆盖完整链路:从GPU封装、导热界面材料、GPU上方的冷板、冷板内部循环冷却液,再到室外把热量排放到大气环境的制冷机组。一套经过精心工程设计的热栈,可以把AI工厂的每瓦生成Token数提升40%以上。该部分增量产出不需要额外消耗资源,带来的营收全部转化为利润。当你理解背后的物理原理,这个数字就不再是营销话术,而是厂区内最显而易见的优化目标。
我们会在下一篇博客完整拆解温度带来巨大影响的底层原理。简单来说,该现象和泄漏功耗、指数级变化关系,以及19世纪化学家斯万特·阿伦尼乌斯(Svante Arrhenius)有关。这里只需要记住核心结论:在电力稀缺、每一瓦电力都弥足珍贵的行业,提升盈利能力最大的抓手,并非更聪明的模型或者更快的芯片,而是热量管控水平。
优化这项关键指标
那么实际落地中,运营方如何提升每瓦生成Token数?优化手段大致分为三类:
第一,芯片与封装选型:
采购阶段确定选用哪款GPU,直接设定了效率基线的上限。
第二,软件与调度效率:
借助更优的模型架构、批处理策略、任务负载排布,在固定功耗下挖掘更多有效算力输出。
第三,热栈(Thermal Stack): 这也是过去绝大多数厂区投入不足的板块。当芯片已经制造完成、软件完成调优,芯片硬件能力就已经确定。热栈就成为剩余最大的优化抓手,释放每一片GPU的价值。
热栈是一整套组件集合,负责把GPU芯片内部的热量导出,最终向外界环境散出。和芯片选型不一样,厂区全生命周期内都可以对热栈迭代改造,而不是仅限于采购阶段。芯片结温会直接显著影响每瓦生成Token数,所以热栈逐步成为杠杆效应最大、最易改造的核心变量。
本系列后续大部分内容,都会围绕第三点展开。因为它的实际价值很高,却获得了最少的行业关注。
现在,请记住核心观点:每瓦生成Token数不只是一项性能统计指标。在电力受限的AI行业,它直接衡量厂区的盈利水平。即便硬件采购、部署全部完成,运营方依旧可以实实在在改善该指标,最主要的手段就是重视热量管理。
下一篇,我们将深入解析温度为什么会带来如此巨大的影响,以及芯片内部温度升高时,硅片层面到底发生了什么。